# HTML Page Scraper App
**URL:** \
**Category:** Showcase\
**Tags:** html\
**Created:** [May 30, 2024, 7:06pm UTC](https://clarionhub.com/t/html-page-scraper-app/7203 "2024-05-30T19:06:45Z")\
**Posts on this page:** 1\
**Page:** 1
**Author:**  [@donridley](https://clarionhub.com/u/donridley)\
**Post date:** [May 30, 2024, 7:06pm UTC](https://clarionhub.com/t/html-page-scraper-app/7203/1 "2024-05-30T19:06:45Z")
"Scrape" files such as JavaScript,CSS,HTML, etc., from a website.
Cannot guarantee it will get all files but it should get most of them.
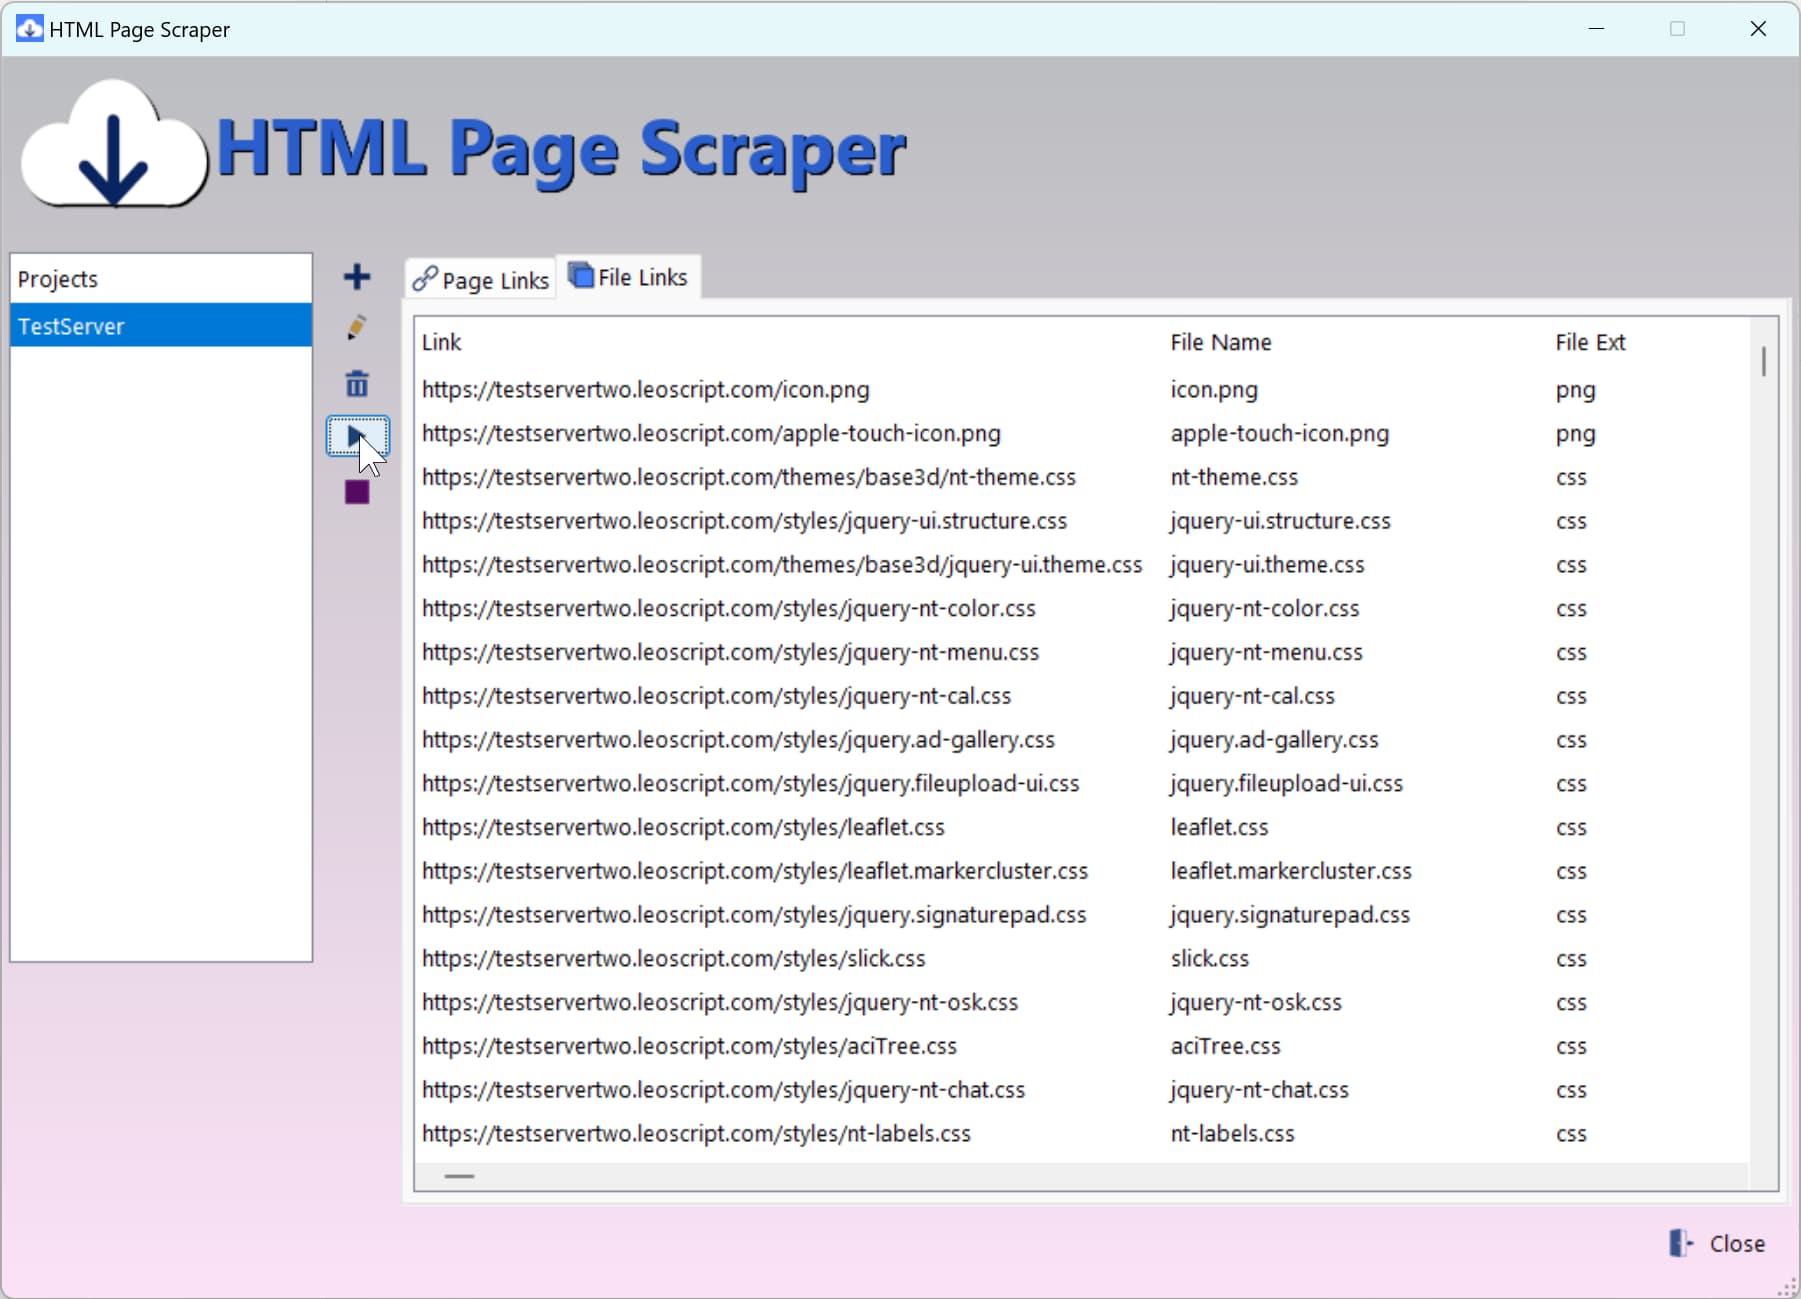
[Download Installer](https://raw.githubusercontent.com/donridley1972/HtmlPageScraper/main/Installer/HtmlPageScraperInstaller.exe)
> **[GitHub - donridley1972/HtmlPageScraper: "Scrapes" files from websites.](https://github.com/donridley1972/HtmlPageScraper)**
>
> "Scrapes" files from websites.